Amazon Luncurkan TorchNeuron agar Kode PyTorch Lebih Mudah Berjalan di Chip Trainium
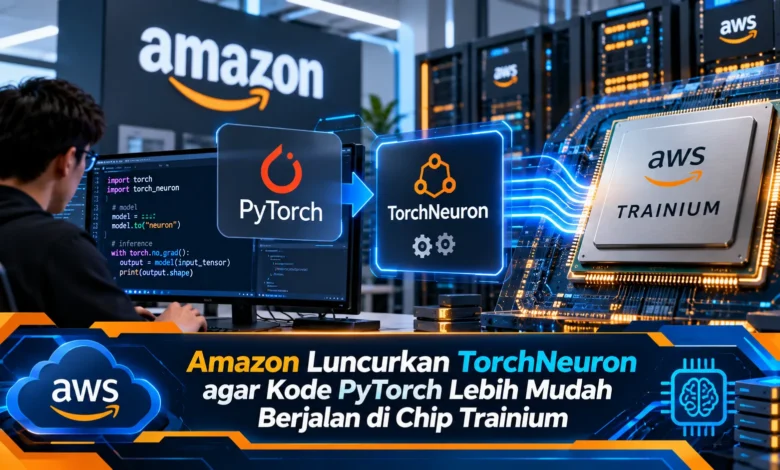
Amazon Web Services (AWS) resmi meluncurkan TorchNeuron dalam versi public beta pada 20 Oktober 2026 sebagai langkah penting untuk menyederhanakan pengembangan kecerdasan buatan. Teknologi open source ini memungkinkan pengembang menjalankan kode PyTorch secara lebih langsung pada chip AWS Trainium tanpa perlu melakukan penulisan ulang aplikasi secara menyeluruh. Kehadiran TorchNeuron memberikan pilihan baru bagi peneliti, perusahaan teknologi, dan pengembang model AI yang membutuhkan infrastruktur komputasi berkinerja tinggi. Melalui integrasi dengan PyTorch, Amazon berupaya mengurangi hambatan penggunaan akselerator AI sekaligus memperluas fleksibilitas pengembangan model machine learning di lingkungan cloud.
Apa Itu TorchNeuron dan Mengapa Penting bagi Pengguna PyTorch?
Melalui pengembangan terbarunya, Amazon meluncurkan TorchNeuron sebagai sistem integrasi PyTorch dengan perangkat keras khusus yang bertujuan menyederhanakan pemrosesan model AI menggunakan AWS Trainium. Sebelumnya, penggunaan kode kecerdasan buatan pada arsitektur chip lain sering melibatkan proses integrasi tambahan. Tantangan seperti ini dapat meningkatkan kompleksitas proyek. Melalui peluncuran framework tersebut, pengembang dapat memanfaatkan kode PyTorch yang sudah tersedia melalui mekanisme kompatibilitas PyTorch native. Kemampuan ini membuka peluang baru bagi komunitas machine learning.
AWS menyediakan TorchNeuron dalam bentuk versi pengujian publik berbasis open source. Pada tahap awal, implementasinya ditujukan bagi Amazon EC2 Trainium2 dan Trainium3. Perangkat keras AI tersebut dikembangkan guna memproses aktivitas pelatihan dan inferensi model yang memerlukan sumber daya besar. Dalam ekosistem perangkat lunaknya, AWS memasukkan TorchNeuron sebagai backend baru pada platform perangkat lunak Neuron. Integrasi tersebut memberikan fondasi untuk eksperimen pembelajaran mesin yang lebih terintegrasi. Namun demikian, setiap proyek tetap membutuhkan validasi teknis sebelum menerapkannya dalam sistem operasional penting.
Mekanisme TorchNeuron untuk Mempermudah Penggunaan Akselerator AI
Secara teknis, TorchNeuron menggunakan mekanisme backend bawaan PyTorch yang dikenal sebagai PrivateUse1. Arsitektur ini menjadikan perangkat Trainium dapat diakses melalui antarmuka PyTorch tanpa mengharuskan pengembang meninggalkan ekosistem PyTorch. Dalam penggunaan sederhana, aplikasi yang menggunakan perangkat CUDA dapat mengubah penempatan perangkat menjadi neuron. Modifikasi konfigurasi tersebut dapat dilakukan dengan menggunakan .to(‘neuron’) sebagai pengaturan perangkat. Dengan cara ini, sebagian besar alur pemrograman standar tetap dapat dipertahankan. Walaupun begitu, dukungan seluruh komponen model tidak boleh langsung diasumsikan.
Backend tersebut menghadirkan mode pemrosesan eager yang menjalankan operasi tensor secara langsung. Mode ini mempermudah eksperimen awal karena peneliti bisa mengevaluasi hasil perhitungan langsung. Sebagai kemampuan tambahan, TorchNeuron menyediakan integrasi dengan torch.compile untuk mengoptimalkan eksekusi model. Melalui mekanisme kompilasi, grafik komputasi dapat dioptimalkan sebelum dieksekusi menggunakan hardware AI. Kombinasi kedua mode tersebut membantu menyeimbangkan kemudahan eksperimen dan performa. Peneliti bisa menggunakan pendekatan pemrosesan yang paling relevan.
Cara TorchNeuron Mendukung Pengoptimalan Komputasi Trainium
Tidak hanya menyediakan dukungan backend native, TorchNeuron juga terhubung dengan Neuron Kernel Interface atau NKI. Antarmuka pemrograman ini memberikan kontrol lebih rinci terhadap pemrosesan tertentu pada sistem komputasi AWS Trainium. Dalam pengembangan model besar, operator standar tidak selalu memberikan performa paling optimal. Dengan memanfaatkan Neuron Kernel Interface, pengembang berpengalaman dapat merancang pemrosesan tingkat rendah yang lebih terarah. Dalam skenario optimasi, operasi tensor tertentu dapat disesuaikan agar menggunakan sumber daya perangkat secara lebih efektif. Walaupun memiliki potensi tersebut, hasil optimasi memerlukan benchmark yang objektif.
Sebagai pelengkap kemampuan optimasi, AWS melengkapi ekosistemnya dengan Neuron Explorer yang membantu menganalisis aktivitas pemrosesan. Berkat dukungan alat profiling PyTorch, pengembang dapat melihat aktivitas komputasi hingga asal instruksi yang dijalankan. Fasilitas tersebut membantu menemukan bagian yang memperlambat pemrosesan. Misalnya, ketika model mengalami keterlambatan, tim teknis bisa memeriksa operasi yang membutuhkan waktu besar. Temuan dari proses profiling kemudian menjadi dasar pengoptimalan kode. Berkat kombinasi alat pengembangan, TorchNeuron menawarkan jalur dari eksperimen menuju penyempurnaan kinerja.
Keunggulan Integrasi PyTorch dengan AWS Trainium
Keuntungan penting yang ditawarkan TorchNeuron adalah pengurangan pekerjaan migrasi perangkat lunak. Pada proyek machine learning, tim biasanya menghabiskan banyak waktu untuk memastikan kompatibilitas model. Ketika migrasi memerlukan adaptasi sistem menyeluruh, biaya pengembangan dapat meningkat. Amazon melalui TorchNeuron mencoba menyederhanakan hambatan kompatibilitas ini dengan mendukung penggunaan kode yang sudah tersedia. Melalui pendekatan tersebut, tim dapat lebih fokus pada eksperimen model. Namun, manfaat nyata perlu dievaluasi berdasarkan model dan kebutuhan komputasi.
Bagi perusahaan teknologi, TorchNeuron memperluas opsi komputasi model melalui AWS Trainium. Pilihan tersebut memungkinkan organisasi mengevaluasi biaya pelatihan model. Dalam skenario penggunaan nyata, biaya komputasi menjadi faktor penting. Perusahaan perlu mempertimbangkan kecepatan pemrosesan model, kemampuan penskalaan, serta kebutuhan pemeliharaan aplikasi. Dengan akses PyTorch yang lebih mudah, perbandingan berbagai pilihan hardware menjadi lebih praktis. Walaupun Amazon menekankan efisiensi Trainium, keuntungan finansial harus dihitung berdasarkan beban kerja.
Peran AWS Trainium dan PyTorch dalam Industri Kecerdasan Buatan
Kehadiran TorchNeuron membuka peluang untuk sejumlah jenis aplikasi kecerdasan buatan. Contoh penggunaan yang relevan adalah pengembangan large language model. Model seperti ini memerlukan pemrosesan matriks yang kompleks. TorchNeuron mendukung mekanisme distributed training standar seperti DistributedDataParallel, FullyShardedDataParallel, dan DTensor. Melalui kemampuan tersebut, tim peneliti memiliki sarana untuk membagi pekerjaan komputasi pada infrastruktur komputasi berskala besar. Meski membuka peluang implementasi, konfigurasi distribusi tetap membutuhkan pengujian.
Di luar pengembangan LLM, TorchNeuron juga relevan untuk eksperimen model generatif gambar dan video. Komunitas peneliti yang mengembangkan model melalui library AI populer berpeluang mencoba backend TorchNeuron melalui dukungan perangkat lunak yang terus dikembangkan. Penggunaan tersebut dapat dimanfaatkan untuk berbagai kebutuhan seperti penelitian model dunia, analisis visual, serta eksperimen ilmiah berbasis AI. Meski demikian, tingkat kompatibilitas tidak selalu identik pada semua aplikasi. Dengan mempertimbangkan hal tersebut, pengembang tetap perlu menguji akurasi hasil sebelum menggunakan Trainium dalam lingkungan operasional penting.
Penutup: Dampak TorchNeuron bagi Masa Depan Komputasi AI
Pengembangan TorchNeuron dalam ekosistem Trainium menunjukkan perkembangan integrasi framework machine learning dan hardware khusus. Berkat mekanisme backend standar, pengembang dapat mencoba AWS Trainium dengan penyesuaian kode yang lebih sedikit. Kemampuan eksekusi langsung, torch.compile, serta Neuron Kernel Interface mendukung berbagai kebutuhan komputasi model. Walaupun masih dalam tahap public beta, TorchNeuron membuka peluang efisiensi dalam eksperimen machine learning. Dalam transformasi TEKNOLOGI komputasi modern, kemudahan berpindah perangkat keras menjadi kebutuhan penting. Dari sudut pandang Anda, seberapa besar pengaruh integrasi PyTorch terhadap pilihan chip AI? Bagikan pemikiran Anda mengenai masa depan infrastruktur AI.