Amazon Luncurkan TorchNeuron agar Kode PyTorch Lebih Mudah Berjalan di Chip Trainium
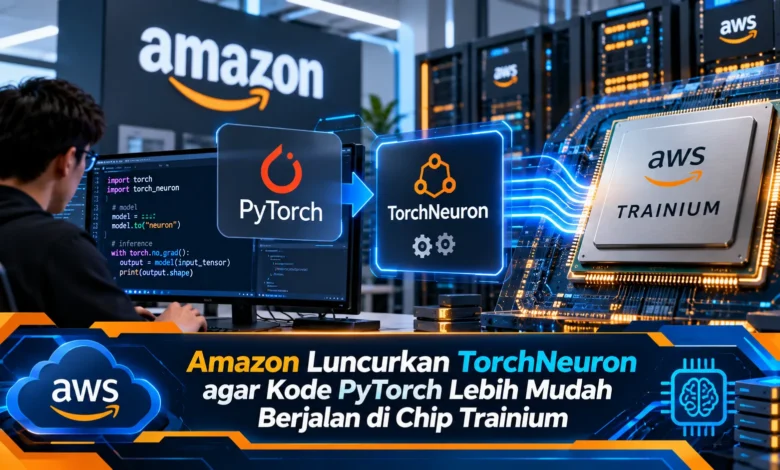
Amazon Web Services (AWS) resmi meluncurkan TorchNeuron dalam versi public beta pada 20 Oktober 2026 sebagai langkah penting untuk menyederhanakan pengembangan kecerdasan buatan. Teknologi open source ini memungkinkan pengembang menjalankan kode PyTorch secara lebih langsung pada chip AWS Trainium tanpa perlu melakukan penulisan ulang aplikasi secara menyeluruh. Kehadiran TorchNeuron memberikan pilihan baru bagi peneliti, perusahaan teknologi, dan pengembang model AI yang membutuhkan infrastruktur komputasi berkinerja tinggi. Melalui integrasi dengan PyTorch, Amazon berupaya mengurangi hambatan penggunaan akselerator AI sekaligus memperluas fleksibilitas pengembangan model machine learning di lingkungan cloud.
Inovasi TorchNeuron untuk Mempermudah Komputasi Kecerdasan Buatan
Amazon memperkenalkan TorchNeuron sebagai backend PyTorch berbasis open source yang bertujuan menyederhanakan pemrosesan model AI menggunakan AWS Trainium. Dalam pendekatan komputasi yang lebih lama, pemindahan model AI ke perangkat keras berbeda sering membutuhkan perubahan kode tertentu. Hambatan kompatibilitas tersebut berpotensi memperpanjang waktu pengembangan. Melalui peluncuran framework tersebut, pengembang dapat memanfaatkan aplikasi AI berbasis PyTorch melalui integrasi perangkat yang lebih sederhana. Kemampuan ini memberikan nilai tambah bagi ekosistem pengembangan AI.
AWS menyediakan TorchNeuron dalam bentuk versi pengujian publik berbasis open source. Pada tahap awal, kompatibilitas utamanya tersedia pada Amazon EC2 Trainium2 dan Trainium3. Perangkat keras AI tersebut dikembangkan guna memproses beban kerja kecerdasan buatan yang memerlukan sumber daya besar. Dalam ekosistem perangkat lunaknya, AWS memasukkan TorchNeuron sebagai bagian dari AWS Neuron SDK. Hubungan antarkomponen ini membuka jalur pengembangan menuju pelatihan model AI yang lebih fleksibel. Namun demikian, status beta berarti pengembang tetap perlu melakukan evaluasi sebelum menerapkannya dalam sistem operasional penting.

Teknologi di Balik Integrasi PyTorch dan Chip Trainium
Dari sisi arsitektur, TorchNeuron memanfaatkan sistem ekstensi perangkat PyTorch yang dikenal sebagai PrivateUse1. Arsitektur ini membantu PyTorch mengidentifikasi akselerator Trainium tanpa memerlukan framework pemrograman yang sepenuhnya berbeda. Sebagai contoh, kode yang sebelumnya menempatkan tensor pada CUDA dapat mengubah penempatan perangkat menjadi neuron. Perubahan tersebut dapat dilakukan dengan menggunakan .to(‘neuron’) sebagai pengaturan perangkat. Berkat dukungan backend native, sebagian besar alur pemrograman standar tetap dapat dipertahankan. Namun, pengujian tetap diperlukan untuk memastikan fungsi aplikasi berjalan benar.
AWS melengkapi TorchNeuron dengan mode pemrosesan eager yang memungkinkan operasi PyTorch dijalankan saat dipanggil. Mode ini mendukung proses debugging model karena tim teknis lebih mudah menelusuri jalannya program. Di luar pemrosesan langsung, TorchNeuron mendukung penggunaan torch.compile untuk menghasilkan pemrosesan berbasis grafik komputasi. Dalam pendekatan tersebut, grafik komputasi dapat dioptimalkan sebelum diproses oleh perangkat Trainium. Pilihan metode eksekusi tersebut memungkinkan pemilihan pendekatan sesuai kebutuhan. Pengembang dapat memilih strategi eksekusi berdasarkan beban kerja.
Cara TorchNeuron Mendukung Pengoptimalan Komputasi Trainium
Tidak hanya menyediakan dukungan backend native, TorchNeuron juga terhubung dengan Neuron Kernel Interface atau NKI. Komponen pengembangan tersebut mendukung pengembangan operasi komputasi yang disesuaikan pada sistem komputasi AWS Trainium. Dalam pengembangan model besar, operator standar tidak selalu memberikan performa paling optimal. Melalui NKI, pengembang berpengalaman dapat merancang implementasi operasi yang sesuai kebutuhan. Dalam skenario optimasi, operasi tensor tertentu dapat dianalisis untuk menemukan hambatan performa. Namun pada penerapan nyata, hasil optimasi memerlukan benchmark yang objektif.
Dalam mendukung analisis performa, AWS menghadirkan perangkat analisis Neuron Explorer yang memungkinkan penelusuran performa aplikasi. Dengan menggunakan data dari torch.profiler, pengembang dapat melihat aktivitas komputasi hingga asal instruksi yang dijalankan. Fasilitas tersebut mendukung pemeriksaan hambatan kinerja. Dalam praktik pengembangan, apabila proses pelatihan berjalan lebih lambat dari harapan, pengembang dapat meninjau profil aktivitas. Hasil analisis tersebut kemudian menjadi dasar pengoptimalan kode. Berkat kombinasi alat pengembangan, TorchNeuron juga mendukung pekerjaan optimasi lanjutan.
Keunggulan Integrasi PyTorch dengan AWS Trainium
Keuntungan penting yang ditawarkan TorchNeuron adalah berkurangnya kompleksitas perpindahan akselerator. Dalam pengembangan kecerdasan buatan, pengembang sering memerlukan sumber daya tambahan untuk menyesuaikan perangkat lunak dengan hardware. Apabila perubahan perangkat keras membutuhkan penulisan ulang besar, beban pekerjaan teknis bisa bertambah. Backend baru ini dirancang untuk mengurangi tantangan tersebut dengan menawarkan akses native ke Trainium. Hasilnya, peneliti memperoleh fleksibilitas dalam memilih hardware. Namun, manfaat nyata perlu dievaluasi berdasarkan model dan kebutuhan komputasi.
Untuk organisasi yang mengembangkan AI, TorchNeuron memperluas opsi komputasi model melalui AWS Trainium. Ketersediaan akselerator tersebut memberikan kesempatan bagi tim infrastruktur untuk menilai performa komputasi berbagai beban kerja. Dalam skenario penggunaan nyata, efisiensi penggunaan akselerator sangat diperhatikan. Pengambil keputusan harus mengevaluasi harga penggunaan instance, durasi pelatihan, serta kompleksitas operasional. Dengan akses PyTorch yang lebih mudah, perbandingan berbagai pilihan hardware menjadi lebih praktis. Walaupun Amazon menekankan efisiensi Trainium, keuntungan finansial harus dihitung berdasarkan beban kerja.
Dukungan TorchNeuron untuk Ekosistem AI dan Model Generatif
Peluncuran integrasi Trainium terbaru membuka peluang untuk sejumlah jenis aplikasi kecerdasan buatan. Sektor yang membutuhkan dukungan komputasi adalah pemrosesan model AI generatif berbasis teks. Sistem bahasa berukuran besar mengandalkan komputasi paralel berkapasitas tinggi. TorchNeuron mendukung fitur pembelajaran model secara paralel seperti DistributedDataParallel, FullyShardedDataParallel, dan DTensor. Dengan dukungan teknologi ini, tim peneliti memiliki sarana untuk membagi pekerjaan komputasi pada lingkungan Trainium yang sesuai. Namun demikian, hasil pelatihan paralel bergantung pada karakteristik model dan infrastruktur.
Di luar pengembangan LLM, TorchNeuron dapat mendukung pekerjaan pengembangan sistem pembelajaran mesin untuk data multimedia. Komunitas peneliti yang mengembangkan model melalui library AI populer dapat mengevaluasi kompatibilitas Trainium melalui ekosistem komputasi Neuron. Penggunaan tersebut membuka kesempatan eksplorasi di sejumlah sektor seperti pemrosesan suara dan bahasa, pengembangan aplikasi generatif, serta eksperimen ilmiah berbasis AI. Meski demikian, dukungan teknis dapat bervariasi antaroperator. Oleh sebab itu, tim teknis harus memvalidasi ketepatan perhitungan sebelum menggunakan Trainium dalam lingkungan operasional penting.
Rangkuman Manfaat TorchNeuron untuk Pengguna PyTorch dan AWS Trainium
Pengembangan TorchNeuron dalam ekosistem Trainium menjadi langkah penting dalam memperluas pilihan akselerator AI. Melalui dukungan PyTorch native, tim rekayasa berpeluang menggunakan kode yang sudah tersedia tanpa migrasi besar. Dukungan mode eager, torch.compile, serta Neuron Kernel Interface membantu eksperimen sekaligus peningkatan performa. Walaupun masih dalam tahap public beta, TorchNeuron memiliki potensi untuk mempermudah penggunaan akselerator AI. Di tengah perkembangan TEKNOLOGI yang semakin pesat, kemudahan berpindah perangkat keras menjadi kebutuhan penting. Menurut Anda, apakah TorchNeuron akan membuat AWS Trainium semakin menarik bagi pengembang AI? Mari sampaikan pandangan tentang perkembangan TorchNeuron.