Tips Mengoptimalkan GPU untuk AI, Maksimalkan Performa Tanpa Boros VRAM
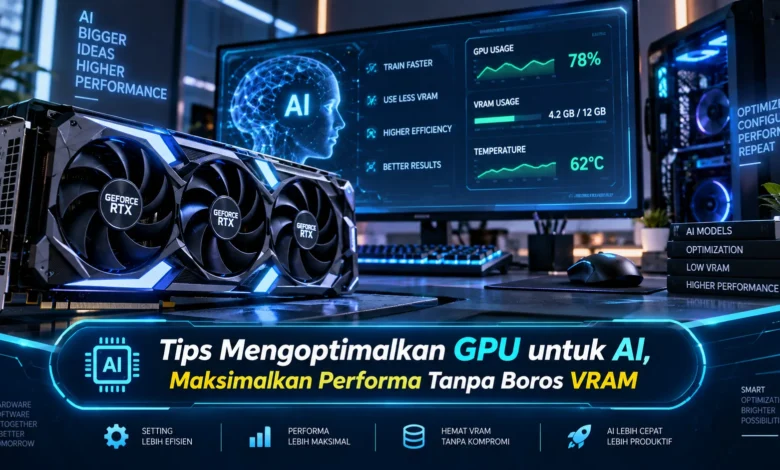
GPU menjadi salah satu komponen terpenting ketika menjalankan workload AI, baik untuk training, fine tuning, inference, maupun eksperimen model lokal. Namun, performa tinggi tidak selalu harus dibayar dengan konsumsi VRAM yang besar. Dengan konfigurasi yang tepat, pengguna dapat meningkatkan efisiensi komputasi sekaligus menjaga penggunaan memori tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI karena model modern terus bertambah kompleks sementara kapasitas perangkat keras tetap memiliki batas tertentu.
Analisis Kebutuhan Memori Sebelum Memulai Workload AI
Langkah pertama untuk mendapatkan performa GPU yang optimal ialah mengetahui seberapa besar memori GPU yang dibutuhkan model. Model AI berukuran besar biasanya membutuhkan kapasitas memori lebih tinggi, terlebih saat model digunakan untuk proses training. Dengan melakukan estimasi dari awal, pengaturan GPU dapat disesuaikan tanpa membebani perangkat secara berlebihan.
Di samping jumlah parameter, batch size, panjang sequence, dimensi input, dan format numerik juga berpengaruh terhadap kebutuhan memori. Semakin berat data yang dimasukkan dalam satu proses, konsumsi memori GPU pun dapat meningkat. Karena itu, pengaturan workload perlu diseimbangkan dengan kapasitas perangkat sehingga performa AI dapat dipertahankan tanpa membuat GPU mengalami out of memory.
Gunakan Precision yang Lebih Efisien untuk Menghemat VRAM
Salah satu cara paling efektif dalam menekan konsumsi memori GPU adalah menjalankan komputasi menggunakan precision yang lebih efisien. Precision FP16 maupun BF16 mampu menggunakan memori lebih sedikit daripada FP32, sekaligus mempertahankan kecepatan komputasi yang tinggi di perangkat GPU generasi baru.
Pelatihan dengan presisi campuran dapat digunakan sebagai strategi efisiensi tambahan karena sebagian operasi dijalankan dengan precision rendah sementara proses tertentu tetap menggunakan precision lebih tinggi. Metode tersebut mampu meningkatkan jumlah data yang diproses sekaligus menurunkan tekanan terhadap VRAM. Dalam ekosistem TEKNOLOGI AI modern, pengelolaan precision menjadi bagian penting dari strategi optimasi GPU.
Batch Size yang Tepat Membantu Mengontrol VRAM
Pengaturan batch memiliki dampak langsung terhadap konsumsi VRAM. Ukuran batch yang berlebihan dapat membuat VRAM cepat penuh, sementara ukuran batch yang terlalu kecil dapat membuat throughput menjadi kurang optimal. Keseimbangan antara keduanya sebaiknya ditentukan berdasarkan kapasitas memori dan jenis workload.
Ketika GPU memiliki VRAM terbatas, teknik gradient accumulation dapat membantu mempertahankan efek batch besar tanpa harus memproses seluruh batch dalam satu waktu. Pendekatan tersebut menjalankan komputasi dalam beberapa tahap, lalu mengakumulasi gradien sebelum optimizer bekerja. Melalui teknik tersebut, kinerja pelatihan dapat dijaga tanpa memerlukan kartu grafis dengan memori sangat besar.
Gunakan Quantization untuk Menjalankan Model Besar Lebih Efisien
Quantization merupakan salah satu pendekatan efektif untuk membuat model AI lebih ringan saat dijalankan. Dengan merepresentasikan parameter menggunakan format yang lebih ringkas, misalnya menggunakan format INT8 atau representasi 4 bit, ukuran model dapat berkurang secara signifikan.
Pendekatan quantization sangat membantu ketika pengguna ingin menjalankan LLM atau model generatif menggunakan GPU dengan VRAM terbatas. Model yang sebelumnya membutuhkan VRAM sangat besar berpotensi dimuat pada perangkat dengan kapasitas VRAM yang lebih kecil. Meski demikian, pengaturan precision tidak sebaiknya dilakukan secara sembarangan karena precision yang terlalu rendah bisa menurunkan kualitas hasil.
Pengelolaan Memori GPU Penting untuk Menjaga Stabilitas AI
Penggunaan VRAM tidak selalu berasal dari model utama, melainkan dapat berasal dari cache, activation, tensor sementara, dan proses tambahan. Oleh sebab itu, pengguna perlu memantau penggunaan GPU secara berkala agar tidak ada aplikasi lain yang menggunakan VRAM tanpa kebutuhan.
Membersihkan cache yang sudah tidak digunakan bisa memberikan ruang VRAM tambahan bagi proses AI selanjutnya. Selain itu, menutup aplikasi grafis atau program lain yang menggunakan GPU juga dapat meningkatkan jumlah VRAM yang tersedia. Manajemen seperti ini terlihat sederhana tetapi memiliki dampak nyata terlebih ketika kapasitas memori GPU tidak terlalu besar.
Optimalkan Software dan Driver untuk Performa GPU Maksimal
Kemampuan GPU tidak semata ditentukan oleh spesifikasi fisik, tetapi juga dipengaruhi oleh driver, library, framework, dan konfigurasi software. Driver GPU yang sesuai mampu menjaga performa sekaligus mengurangi masalah kompatibilitas, terutama ketika menggunakan framework AI terbaru.
Perangkat lunak AI terkini sering menghadirkan fitur penghematan memori termasuk mekanisme attention efisien, kernel khusus, dan pemrosesan yang lebih terintegrasi. Memilih kombinasi driver dan framework yang kompatibel mampu membuat GPU bekerja lebih efisien tanpa menambah kapasitas perangkat. Dengan demikian, optimalisasi software sama pentingnya dengan memilih kartu grafis yang kuat.
Cara Menjaga GPU AI Tetap Cepat dan Hemat VRAM
Mengoptimalkan GPU untuk AI bukan hanya soal menggunakan kartu grafis dengan VRAM terbesar. Pengaturan precision, ukuran batch, kompresi model, pemantauan VRAM, serta optimasi software dapat meningkatkan performa sekaligus mengurangi penggunaan memori. Melalui konfigurasi yang sesuai, perangkat dapat menangani model yang lebih kompleks tanpa langsung kehabisan memori.
Kemajuan TEKNOLOGI kecerdasan buatan terus menghadirkan teknik baru untuk menghemat sumber daya. Dengan demikian, strategi optimasi sebaiknya tidak hanya berpusat pada kekuatan GPU, namun juga memperhatikan pengaturan model, framework, dan penggunaan memori. Melalui pengelolaan yang tepat, GPU dapat bekerja lebih optimal dengan penggunaan VRAM yang tetap efisien. Pembaca dapat melakukan pengujian bertahap agar memperoleh keseimbangan terbaik antara kecepatan, penggunaan VRAM, dan kualitas hasil.