Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud
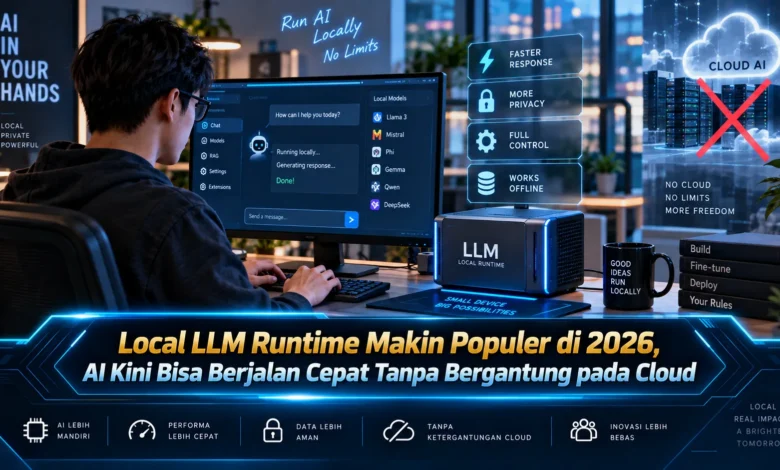
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
Local LLM Runtime Membawa Perubahan Besar pada Penggunaan AI
Popularitas Local LLM Runtime terus meningkat karena pengguna mulai membutuhkan AI yang dapat bekerja secara cepat tanpa selalu bergantung pada koneksi menuju server eksternal. Dengan menjalankan model secara langsung di perangkat, proses permintaan dan respons dapat dilakukan di dalam sistem lokal sehingga sebagian pekerjaan tidak perlu dikirim menuju pusat data jarak jauh. Kemajuan ini menjadikan TEKNOLOGI AI lebih mudah disesuaikan karena pengguna dapat menentukan apakah model dijalankan melalui perangkat sendiri atau menggunakan layanan daring.
Tren tersebut juga didorong oleh semakin banyaknya model yang dirancang agar dapat berjalan pada perangkat dengan sumber daya lebih terbatas dibandingkan generasi sebelumnya. Metode seperti quantization dapat menurunkan kebutuhan memori sehingga model dapat dijalankan dalam format yang lebih efisien pada perangkat lokal. Dampaknya, kecerdasan buatan lokal tidak lagi terbatas pada eksperimen pengembang tetapi semakin relevan untuk pekerjaan harian.

Kecepatan Menjadi Salah Satu Keunggulan Local LLM Runtime
Salah satu daya tarik Local LLM Runtime adalah kemampuan memberikan respons tanpa harus menunggu perjalanan data dari perangkat menuju server cloud lalu kembali lagi kepada pengguna. Jika komputer memiliki CPU, GPU, NPU, serta kapasitas memori yang sesuai, model dapat memproses banyak tugas dengan waktu respons yang relatif cepat. Kecepatan AI lokal tetap ditentukan oleh sejumlah faktor seperti ukuran model, panjang input, optimasi perangkat lunak, jenis quantization, dan kemampuan hardware.
Penggunaan lokal juga dapat memberikan pengalaman yang lebih stabil ketika koneksi internet sedang lambat atau tidak tersedia. Pengguna yang sering bekerja dengan dokumen, kode, maupun catatan dapat menjalankan model tanpa harus bergantung pada kondisi jaringan selama seluruh komponen yang diperlukan sudah tersedia pada perangkat. Kondisi ini membuat TEKNOLOGI kecerdasan buatan lokal cocok bagi pengguna yang ingin memiliki akses AI yang lebih mandiri terhadap kondisi internet.
Privasi Data Menjadi Alasan Banyak Pengguna Memilih AI Lokal
Selain performa, privasi menjadi salah satu alasan penting mengapa Local LLM Runtime semakin banyak diperhatikan karena data dapat diproses secara langsung pada perangkat pengguna. Informasi seperti dokumen kerja, catatan pribadi, maupun kode dapat diproses di komputer sendiri selama aplikasi tidak dikonfigurasi untuk meneruskannya ke layanan luar. Pendekatan tersebut dapat memberikan kontrol yang lebih besar kepada pengguna mengenai lokasi data diproses dan aplikasi apa saja yang memiliki akses terhadap informasi tersebut.
Walaupun proses dilakukan secara lokal, keamanan tidak otomatis terjamin karena masih bergantung pada pengaturan sistem, perangkat lunak, jaringan, serta cara pengguna mengelolanya. Perangkat yang terinfeksi malware atau memiliki akses pengguna yang tidak terlindungi tetap dapat membahayakan informasi yang tersimpan secara lokal. Itulah mengapa TEKNOLOGI kecerdasan buatan lokal tetap membutuhkan perlindungan melalui pembaruan perangkat, enkripsi, autentikasi, dan pengelolaan izin yang baik.
GPU NPU dan Memori Menjadi Penggerak Local LLM Runtime
Perkembangan perangkat keras menjadi salah satu faktor utama yang membuat Local LLM Runtime semakin praktis karena komputer modern memiliki kemampuan pemrosesan AI yang terus meningkat. Keberadaan GPU membantu mempercepat komputasi model sementara NPU mulai digunakan untuk menjalankan beban AI dengan konsumsi sumber daya yang lebih terarah. Jumlah RAM maupun memori GPU menjadi faktor penting sebab model dan konteks perlu ditempatkan dalam memori ketika proses inferensi dilakukan.
Pengguna tidak selalu membutuhkan perangkat kelas tertinggi karena model yang lebih kecil dan teroptimasi dapat memberikan hasil yang memadai untuk berbagai pekerjaan ringan hingga menengah. Model sebaiknya dipilih berdasarkan spesifikasi komputer dan kebutuhan tugas agar pengguna tidak menjalankan ukuran yang terlalu berat bagi perangkat. Fleksibilitas memilih model membuat TEKNOLOGI Local LLM dapat digunakan pada lebih banyak jenis perangkat tanpa selalu membutuhkan konfigurasi paling mahal.
Penggunaan Local LLM Mulai Meluas untuk Pekerjaan Sehari Hari
AI lokal dapat digunakan untuk beragam pekerjaan mulai dari merangkum informasi, membantu penulisan, menganalisis dokumen, hingga mendampingi pengembangan perangkat lunak. Bagi pengembang, model lokal dapat diintegrasikan dengan perangkat lunak sehingga fitur AI dapat berjalan langsung di lingkungan pengguna. Hal ini mendorong perkembangan aplikasi yang tidak terlalu bergantung pada layanan jarak jauh sekaligus menawarkan kontrol data yang lebih besar.
Di organisasi, Local LLM dapat mendukung pencarian data internal, penyusunan informasi, maupun otomatisasi pekerjaan selama penggunaan mengikuti kebijakan keamanan. Model lokal dapat dipadukan dengan sumber pengetahuan internal untuk menghasilkan respons yang lebih berkaitan dengan kebutuhan pengguna. Kemampuan tersebut memperlihatkan potensi TEKNOLOGI Local LLM sebagai komponen kerja yang dapat dihubungkan dengan beragam aplikasi serta sistem informasi.
AI Lokal Tidak Sepenuhnya Menggantikan Cloud
Pertumbuhan Local LLM tidak otomatis menggantikan layanan cloud karena masing masing metode menawarkan manfaat sesuai kebutuhan pengguna. Pemrosesan cloud tetap relevan bagi model dengan kebutuhan sumber daya besar sementara Local LLM menawarkan keuntungan untuk tugas yang dapat ditangani langsung di perangkat. Keputusan menggunakan lokal atau cloud dapat disesuaikan dengan karakter tugas, kapasitas hardware, kebutuhan keamanan data, dan faktor biaya.
Sistem hybrid dapat menjadi pilihan populer dengan menjalankan proses ringan di perangkat sementara tugas kompleks diproses menggunakan infrastruktur cloud. Model seperti ini dapat memberikan keseimbangan antara kecepatan, privasi, kemampuan komputasi, dan fleksibilitas penggunaan. Kondisi tersebut memperlihatkan bahwa TEKNOLOGI AI masa depan berpotensi menggunakan kombinasi antara komputasi perangkat dan infrastruktur cloud secara lebih fleksibel.
Kesimpulan Local LLM Runtime dan Masa Depan AI Lokal
Local LLM Runtime menunjukkan perubahan penting pada 2026 ketika AI semakin mudah diproses secara langsung melalui perangkat pengguna tanpa ketergantungan penuh terhadap layanan cloud. Keuntungan seperti latensi yang rendah, kemampuan bekerja tanpa internet, kontrol data yang lebih besar, dan fleksibilitas pemilihan model membuat pendekatan ini menarik bagi pengguna biasa maupun pengembang. Perkembangan perangkat keras serta teknik optimasi membuat penggunaan AI lokal semakin mudah tanpa selalu bergantung pada perangkat kelas tertinggi. Seiring kemajuan TEKNOLOGI, Local LLM berpotensi menjadi komponen penting dalam masa depan AI dengan memberikan pilihan antara pemrosesan lokal, cloud, maupun kombinasi keduanya.