Tips Mengoptimalkan GPU untuk AI, Maksimalkan Performa Tanpa Boros VRAM
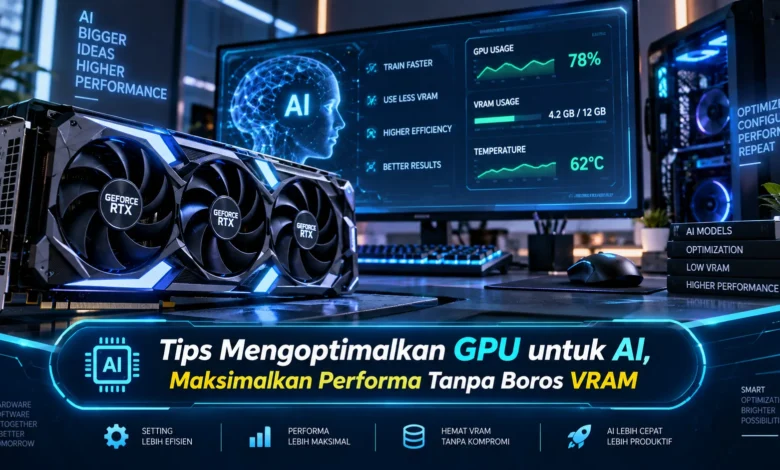
GPU menjadi salah satu komponen terpenting ketika menjalankan workload AI, baik untuk training, fine tuning, inference, maupun eksperimen model lokal. Namun, performa tinggi tidak selalu harus dibayar dengan konsumsi VRAM yang besar. Dengan konfigurasi yang tepat, pengguna dapat meningkatkan efisiensi komputasi sekaligus menjaga penggunaan memori tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI karena model modern terus bertambah kompleks sementara kapasitas perangkat keras tetap memiliki batas tertentu.
Analisis Kebutuhan Memori Sebelum Memulai Workload AI
Tahap awal ketika ingin meningkatkan efisiensi GPU AI ialah mengetahui seberapa besar memori GPU yang dibutuhkan model. Model dengan jumlah parameter besar biasanya membutuhkan kapasitas memori lebih tinggi, terutama saat melakukan training atau fine tuning. Jika kebutuhan memori sudah diketahui sebelumnya, pengguna dapat mengatur parameter komputasi secara lebih efisien.
Bukan hanya ukuran model, batch size, panjang konteks, resolusi data, dan precision juga memengaruhi penggunaan VRAM. Makin besar jumlah data yang diproses secara bersamaan, semakin banyak VRAM yang dibutuhkan. Oleh sebab itu, beban komputasi sebaiknya dirancang sesuai kapasitas VRAM sehingga performa AI dapat dipertahankan tanpa membuat GPU mengalami out of memory.

Kurangi Konsumsi Memori dengan Mixed Precision
Salah satu metode yang cukup efektif untuk menghemat kapasitas memori grafis adalah menggunakan precision yang lebih rendah. Representasi numerik seperti FP16 dan BF16 biasanya memerlukan kapasitas VRAM lebih kecil dibandingkan precision penuh, tanpa mengorbankan performa secara signifikan pada kartu grafis yang mendukung akselerasi AI.
Mixed precision training juga dapat menjadi pilihan menarik karena sebagian operasi dijalankan dengan precision rendah sementara proses tertentu tetap menggunakan precision lebih tinggi. Strategi tersebut mampu meningkatkan jumlah data yang diproses sambil mengurangi beban memori GPU. Pada perkembangan TEKNOLOGI kecerdasan buatan saat ini, pengelolaan precision menjadi bagian penting dari strategi optimasi GPU.
Sesuaikan Batch Size dengan Kapasitas GPU
Pengaturan batch memiliki dampak langsung terhadap konsumsi VRAM. Ukuran batch yang berlebihan bisa menyebabkan konsumsi VRAM melonjak, sementara ukuran batch yang terlalu kecil dapat membuat throughput menjadi kurang optimal. Pengaturan yang proporsional harus disesuaikan dengan spesifikasi GPU.
Ketika GPU memiliki VRAM terbatas, pengguna dapat memanfaatkan gradient accumulation untuk memperoleh hasil serupa dengan batch besar tanpa memuat seluruh data secara bersamaan ke dalam GPU. Metode ini memproses data secara bertahap, selanjutnya mengumpulkan gradien sebelum parameter model diperbarui. Dengan cara ini, pengguna dapat mempertahankan efisiensi training tanpa membutuhkan VRAM yang terlalu besar.
Gunakan Quantization untuk Menjalankan Model Besar Lebih Efisien
Quantization merupakan salah satu pendekatan efektif untuk membuat model AI lebih ringan saat dijalankan. Melalui pengurangan precision pada bobot model, misalnya menggunakan format INT8 atau representasi 4 bit, ukuran model dapat berkurang secara signifikan.
Pendekatan quantization cukup efektif untuk kebutuhan inference maupun penggunaan model bahasa besar di perangkat lokal. Arsitektur yang semula terlalu berat untuk GPU tertentu bisa dijalankan dengan kebutuhan memori lebih rendah. Namun, penggunaan quantization tetap perlu disesuaikan dengan kebutuhan sebab kompresi numerik berlebihan berpotensi menurunkan akurasi model.
Pengelolaan Memori GPU Penting untuk Menjaga Stabilitas AI
Konsumsi memori GPU tidak hanya disebabkan oleh bobot model, tetapi turut dipengaruhi oleh buffer, cache, tensor aktif, dan aplikasi lain. Oleh sebab itu, pemakaian memori GPU sebaiknya diperiksa secara rutin agar tidak ada aplikasi lain yang menggunakan VRAM tanpa kebutuhan.
Melepaskan alokasi memori yang sudah selesai digunakan mampu mengurangi fragmentasi dan memberi kapasitas lebih besar untuk model. Tidak hanya itu, menghentikan software lain yang memanfaatkan akselerasi grafis bisa membebaskan sebagian kapasitas memori grafis. Manajemen seperti ini mungkin tampak sederhana namun cukup berpengaruh khususnya untuk GPU kelas menengah.
Software yang Tepat Membantu GPU AI Bekerja Lebih Efisien
Performa GPU tidak hanya bergantung pada hardware, tetapi turut bergantung pada optimasi driver, library komputasi, dan software yang digunakan. Driver grafis yang tepat dapat meningkatkan stabilitas dan kompatibilitas, khususnya saat menjalankan library machine learning modern.
Perangkat lunak AI terkini umumnya menawarkan mekanisme efisiensi komputasi termasuk mekanisme attention efisien, kernel khusus, dan pemrosesan yang lebih terintegrasi. Menjaga lingkungan perangkat lunak tetap optimal bisa memberikan peningkatan kecepatan tanpa membeli hardware baru. Oleh sebab itu, pengaturan software perlu mendapatkan perhatian yang sama seperti spesifikasi GPU.
Cara Menjaga GPU AI Tetap Cepat dan Hemat VRAM
Mengoptimalkan GPU untuk AI bukan hanya soal menggunakan kartu grafis dengan VRAM terbesar. Kombinasi mixed precision, batch yang tepat, quantization, manajemen memori, dan konfigurasi framework mampu membantu GPU bekerja jauh lebih efektif. Dengan strategi yang tepat, perangkat dapat menangani model yang lebih kompleks tanpa langsung kehabisan memori.
Perkembangan TEKNOLOGI AI terus mendorong hadirnya metode komputasi yang semakin efisien. Karena itu, pengguna sebaiknya tidak hanya mengejar spesifikasi hardware, melainkan turut mempelajari konfigurasi workload dan lingkungan software. Melalui pengelolaan yang tepat, performa AI dapat dimaksimalkan tanpa membuat VRAM terbuang sia sia. Pembaca dapat melakukan pengujian bertahap agar memperoleh keseimbangan terbaik antara kecepatan, penggunaan VRAM, dan kualitas hasil.