Meta MTIA 2026 Makin Serius Tantang GPU, Chip AI Internal Meta Kini Masuk Era Training Skala Besar
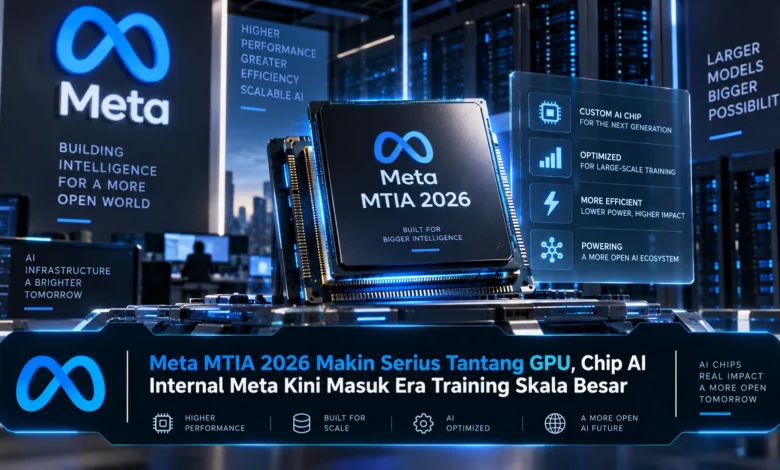
Persaingan infrastruktur kecerdasan buatan pada 2026 tidak lagi hanya berpusat pada model AI, tetapi juga pada chip yang menjalankan proses komputasinya. Meta semakin serius mengembangkan Meta Training and Inference Accelerator atau MTIA sebagai keluarga chip internal yang dirancang untuk kebutuhan AI perusahaan. MTIA kini berkembang dari fokus awal pada inference menuju training untuk beban kerja ranking dan recommendation berskala besar. Langkah tersebut memperlihatkan bagaimana TEKNOLOGI chip khusus mulai menjadi bagian penting dalam strategi perusahaan besar untuk meningkatkan efisiensi pusat data dan mengurangi ketergantungan pada satu jenis akselerator komputasi.
Chip Internal Meta Mulai Menangani Training Skala Besar
Akselerator AI internal Meta terus memperluas kemampuannya sebagai komponen penting dalam strategi pusat data Meta. Apabila sebelumnya MTIA dikenal melalui fokus inference, generasi terbaru semakin diarahkan untuk menangani pelatihan model sehingga perannya di pusat data semakin besar.
Ekspansi kemampuan tersebut memperlihatkan bahwa Meta tidak sekadar bereksperimen dengan chip internal. Dengan merancang chip untuk beban kerja internal, perusahaan dapat mengoptimalkan efisiensi komputasi dibandingkan mengandalkan solusi serbaguna pada setiap workload. Strategi semacam ini menjadi salah satu arah penting TEKNOLOGI pusat data ketika beban kerja AI berkembang dengan cepat.

MTIA 300 Membawa Training ke Level Produksi
Generasi MTIA 300 menandai perubahan besar karena ditujukan menangani workload ranking dan recommendation. Jenis model tersebut memiliki pola kebutuhan hardware tersendiri, terutama ketika training membutuhkan pertukaran data antarakselerator secara intensif.
Bukan hanya berfokus pada daya hitung, Meta mendesain jalur komunikasi sebagai bagian utama sistem. Desain semacam itu sangat relevan pada proses training ranking karena komunikasi berlangsung intensif selama training. Melalui rancangan tersebut, peningkatan performa tidak hanya ditentukan oleh jumlah unit komputasi, tetapi juga ditentukan kualitas jaringan internal.
Arsitektur MTIA Fokus Mengurangi Hambatan Komunikasi
Bagian penting dari desain MTIA 300 adalah penggunaan mesin komunikasi khusus. Tujuannya agar pertukaran data tidak terlalu membebani unit komputasi sehingga hardware dapat mempertahankan efisiensi lebih baik.
Pada klaster AI berskala tinggi, kecepatan pertukaran data memiliki peran besar. Apabila komunikasi menjadi hambatan, pemrosesan tidak dapat dimanfaatkan secara maksimal. Dengan alasan tersebut, desain yang menyesuaikan library komunikasi dengan akselerator dapat meningkatkan efisiensi training khusus.
Custom Silicon dan GPU Akan Berjalan Bersama
Meski perkembangan MTIA semakin agresif, hal tersebut tidak otomatis membuat GPU kehilangan perannya. Perusahaan menjalankan strategi kombinasi hardware dengan menggabungkan beberapa pilihan hardware sesuai jenis workload yang dijalankan.
GPU tetap memiliki keunggulan karena memiliki ekosistem software luas, terutama untuk workload dengan kebutuhan komputasi umum yang berat. Di sisi lain, MTIA dapat dioptimalkan secara khusus untuk workload Meta. Strategi hybrid tersebut memungkinkan perusahaan memilih akselerator berdasarkan efisiensi daripada menggunakan solusi yang sama pada seluruh sistem.
Custom Silicon Memberikan Ruang Optimasi Lebih Dalam
Keuntungan terbesar chip internal terletak pada fleksibilitas menyesuaikan desain dengan workload. Meta mengetahui karakter aplikasi dan modelnya, sehingga desain silikon dapat diarahkan pada pola komputasi tertentu.
Pengembangan sistem secara menyeluruh juga membuka kesempatan tuning yang lebih luas. Lapisan aplikasi hingga arsitektur chip dapat dioptimalkan sebagai satu kesatuan. Ketika diterapkan pada ratusan ribu akselerator, peningkatan efisiensi yang terlihat kecil pada satu chip dapat menghasilkan penghematan signifikan pada skala luas.
Siklus Pengembangan MTIA Semakin Agresif
Rencana custom silicon Meta menunjukkan siklus pengembangan yang semakin cepat. Tim MTIA merancang beberapa generasi setelah MTIA 300, termasuk MTIA 400, MTIA 450, dan MTIA 500, untuk memperluas cakupan workload.
Pendekatan iteratif tersebut memungkinkan arsitektur akselerator diperbarui lebih sering. Strategi tersebut semakin relevan karena kebutuhan komputasi berkembang dalam waktu singkat. Hardware yang mulai dikembangkan sekarang harus mampu menangani model pada masa implementasi, sehingga desain modular dan pengembangan cepat menjadi strategi yang menarik dalam perkembangan TEKNOLOGI AI.
Kesimpulan
Perkembangan MTIA pada 2026 menunjukkan bahwa kompetisi komputasi AI tidak lagi sederhana. Perluasan MTIA dari inference menuju training tertentu menjadi langkah penting bagi strategi custom silicon Meta. Desain yang disesuaikan dengan workload internal memberikan peluang meningkatkan efisiensi pada training AI berskala besar.
Walaupun MTIA semakin serius, persaingan dengan GPU kemungkinan besar berlangsung melalui pembagian workload. Platform eksternal dan MTIA dapat saling melengkapi dalam pusat data generasi berikutnya. Bagi pembaca yang mengikuti TEKNOLOGI, perjalanan MTIA patut dipantau lebih lanjut karena persaingan hardware AI memasuki fase yang semakin menarik.